
Principal conclusão:
A corrida da IA por dados melhores criou uma controvérsia inesperada: empresas podem estar transformando séculos de conhecimento humano em material de treinamento para IA, enquanto livros físicos raros desaparecem. O debate não se limita mais à tecnologia — agora questiona se o progresso deve ocorrer à custa da preservação cultural.
Uma publicação recente viralizou no X , alcançando mais de 23 milhões de visualizações , com uma afirmação que parece saída de um romance distópico:
Empresas de inteligência artificial estão comprando livros raros em grandes quantidades, cortando suas lombadas com máquinas de alta velocidade, digitalizando cada página e destruindo os originais em seguida.
Para quem vê os livros como algo mais do que meros recipientes de palavras, a ideia parece quase impossível de aceitar.
Por que alguém gastaria milhares de dólares em um livro raro — apenas para destruí-lo?
A resposta é que o juiz disse que é legal.
"Destruímos livros raros e oferecemos acordos de confidencialidade para que ninguém descubra " é um modelo de negócio legítimo em 2026.
Então, por que empresas de IA estão comprando milhões de livros apenas para destruí-los? Como isso é sequer legal e por que o público está tão furioso? Vamos analisar a história.
Por que as empresas de IA estão comprando milhões de livros?
Os livros se tornaram material valioso para treinamento em IA.
Os modelos modernos de IA exigem enormes quantidades de texto de alta qualidade para aprender linguagem, raciocínio, estilos de escrita e conhecimento factual.
Os livros estão entre as fontes mais ricas de dados de treinamento porque contêm:
- Explicações detalhadas
- Conhecimento especializado
- Recordes historicos
- Criatividade humana e narrativa
Livros mais antigos são especialmente valiosos porque foram criados antes da explosão de conteúdo gerado por IA, tornando-os menos propensos a conter material escrito por máquinas.
Para as empresas de IA que competem para construir modelos mais poderosos, milhões de livros representam algo mais do que papel — representam bilhões de exemplos do conhecimento humano.
Projeto Panamá: A Corrida Antropológica por Mais Livros
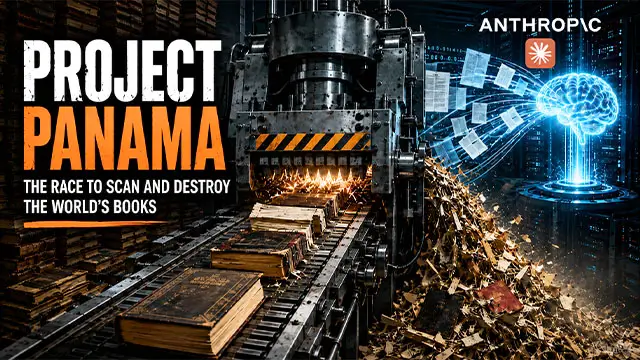
A dimensão dessa demanda ficou clara em 2024, quando a Anthropic lançou o Projeto Panamá , um esforço revelado por documentos judiciais para adquirir e digitalizar milhões de livros de forma destrutiva para treinar seus modelos de IA por trás de Claude. A empresa teria gasto dezenas de milhões de dólares comprando livros e trabalhou com fornecedores de digitalização capazes de converter de 500,000 mil a 2 milhões de livros em seis meses, cortando as encadernações e digitalizando páginas individuais.
A parte que chocou as pessoas: por que destruir os livros originais?
A digitalização não destrutiva de um livro é um trabalho meticuloso. Um operador humano precisa virar manualmente cada página sob uma câmera suspensa de alta resolução, levando horas por volume para garantir que as páginas não sejam danificadas ou borradas.
Para empresas que operam em escala industrial, a digitalização manual é muito lenta. A maneira mais rápida de digitalizar milhões de páginas é a digitalização destrutiva:
Uma guilhotina industrial corta a encadernação colada ou costurada diretamente da lombada.
As folhas soltas são inseridas em scanners de alimentação automática de alta velocidade, capazes de capturar centenas de páginas por minuto.
Após a geração da cópia digital de alta resolução, o papel solto e não encadernado é descartado ou reciclado.
Para os engenheiros que se concentram exclusivamente na ingestão de dados, o arquivo digital é o livro. O papel era apenas um veículo temporário que continha o código.
Mas, para arquivistas e historiadores, essa lógica desmorona quando aplicada a obras raras ou esgotadas. Quando um texto histórico raro existe em apenas algumas dezenas de exemplares físicos no mundo todo, destruir um artefato permanente para obter uma versão digital proprietária representa uma perda irreversível.
Por que isso seria permitido?
O principal motivo pelo qual essa prática pode se expandir é simples: as empresas acreditam que ela é legal.
Empresas de IA argumentam que usar livros para treinar modelos de IA é uma forma de uso transformador, semelhante à maneira como os humanos aprendem lendo obras existentes.
O argumento deles:
- A IA não se limita a reproduzir livros inteiros.
- O treinamento cria um novo sistema.
- Aprender com o conhecimento existente impulsiona a inovação.
Algumas decisões judiciais envolvendo a digitalização de livros por meio de inteligência artificial corroboraram parte desse argumento com base nos princípios do uso justo.
A IA está aprendendo com livros — ou extraindo informações deles?
Existem duas perspectivas diferentes:
A indústria afirma que é assim que todo o conhecimento progride.
Os defensores da IA comparam o treinamento de IA ao aprendizado humano.
Um escritor lê milhares de livros antes de criar um romance.
Um cientista estuda pesquisas anteriores antes de fazer descobertas.
Um engenheiro aprende com a tecnologia existente antes de inventar algo novo.
Dessa perspectiva, a IA está fazendo algo semelhante:
Absorver o conhecimento humano e criar novas capacidades.
Críticos afirmam que a IA é diferente devido à escala.
O problema, argumentam os críticos, não é a aprendizagem.
Trata-se de extração industrial.
Uma pessoa pode ler milhares de livros ao longo da vida.
Uma empresa de IA consegue processar milhões de livros em meses.
A crítica é a seguinte:
Os criadores humanos passaram décadas produzindo conhecimento.
As empresas estão convertendo esse conhecimento em sistemas comerciais de IA que podem competir com esses mesmos criadores.
A questão passa a ser:
A IA está expandindo o conhecimento humano — ou capturando seu valor econômico?
Por que os acordos de confidencialidade pioraram a controvérsia?
“Preservação Digital” ou “Manter em Segredo”?
A destruição de livros é apenas uma parte da controvérsia.
A outra é o sigilo.
Os críticos apontam para:
- Acordos de dados privados
- Acordos de não divulgação
- Transparência limitada sobre as fontes de treinamento
Uma publicação viral argumentou que as empresas poderiam descrever o processo como "preservação digital", mantendo os detalhes ocultos do público.
Isso gerou uma preocupação ainda maior:
Se isso é benéfico para a sociedade, por que precisa acontecer a portas fechadas?
Um possível ponto de virada: a IA poderia aprender sem destruir livros?
A controvérsia já começou a mudar a conversa dentro da indústria de IA.
Em resposta à discussão viral, Elon Musk comentou que havia pedido à equipe de IA da SpaceX para adotar uma abordagem diferente:
A mensagem sugere um meio-termo:
As empresas de IA ainda podem coletar dados de treinamento valiosos — mas livros raros e historicamente significativos devem ser tratados como artefatos culturais, e não como fontes descartáveis de informação.
A diferença não reside em saber se os livros devem ou não ser digitalizados.
Quase todos concordam que a digitalização pode preservar o conhecimento.
A questão é como essa digitalização acontece.
Para livros comuns, a digitalização destrutiva pode ser simplesmente uma opção prática e eficiente.
Para um dos últimos exemplares sobreviventes de uma importante obra histórica, a preservação pode ser mais importante do que a velocidade.
A resposta de Musk destaca o maior desafio que a indústria de IA enfrenta:
Será que as empresas conseguem construir sistemas de IA mais poderosos, respeitando ao mesmo tempo a história física por trás dos dados que consomem?
A grande questão: a quem pertence o conhecimento humano?
A controvérsia dos livros raros representa um debate muito mais amplo sobre inteligência artificial.
Todo modelo de IA é construído a partir de coisas criadas por humanos:
- Livros
- Artigos
- Music
- Imagens
- Software
- Pesquisa científica
A questão central já não é apenas:
A IA pode aprender com o conhecimento humano?
Isto é:
Quem deve se beneficiar quando o conhecimento humano se torna a base da inteligência artificial?
Se os dados não forem divulgados, como as pessoas saberiam que o trabalho dele/dela foi utilizado?