
Conclusão principal: Os grandes modelos de linguagem têm dominado os holofotes da IA, mas uma revolução silenciosa está em curso: os pequenos modelos de linguagem (SLMs, na sigla em inglês) estão provando que escala não é tudo. Ao se concentrarem em dados de alta qualidade e arquiteturas eficientes, os SLMs podem igualar ou até mesmo superar modelos muito maiores em tarefas específicas, executando mais rapidamente, custando menos e preservando a privacidade. Para a maioria das aplicações comerciais e de consumo do mundo real, menor costuma ser mais inteligente.
O problema com maquetes gigantes
Modelos de ponta como o GPT-4 e o PaLM-2 contêm centenas de bilhões — às vezes mais de um trilhão — de parâmetros. Suas capacidades são extraordinárias, mas apresentam desvantagens significativas. Eles exigem centros de dados gigantescos, consomem quantidades enormes de eletricidade e são caros para treinar e manter. De acordo com um estudo de 2022 realizado por Hoffmann et al. na DeepMind, muitos modelos grandes são subtreinados em relação ao seu tamanho, o que significa que seu desempenho poderia ser melhorado com dados melhores em vez de mais parâmetros. Essa descoberta, conhecida como as “leis de escala da chinchila”, desafiou a suposição de que modelos maiores são automaticamente melhores.
Empresas e desenvolvedores também enfrentam obstáculos práticos: custos de API, latência, dependência de fornecedores e preocupações com a privacidade dos dados. Enviar dados confidenciais de clientes para um megamodelo remoto pode ser inaceitável para aplicações nas áreas de saúde, finanças e direito. É aí que os modelos de linguagem menores se destacam.
O que são pequenos modelos de linguagem?
Modelos de linguagem pequenos geralmente variam de alguns milhões a alguns bilhões de parâmetros — até 100 vezes menores que os modelos de linguagem de última geração . Exemplos incluem o Phi 3 Mini da Microsoft (3.8 bilhões de parâmetros), o Gemma do Google (2 bilhões/7 bilhões), o Llama 3.2 da Meta (1 bilhão/3 bilhões) e o TinyLlama de código aberto (1.1 bilhão). Apesar do tamanho compacto, esses modelos são surpreendentemente capazes. A Microsoft relata que o Phi 3 Mini iguala ou supera modelos com o dobro do seu tamanho em muitos benchmarks de compreensão de linguagem, graças a dados de treinamento cuidadosamente selecionados e com qualidade de livro didático, em vez de coleta indiscriminada de dados da web.
Outro exemplo é o DistilBERT , uma versão simplificada do modelo BERT do Google. Ele retém 97% da capacidade de compreensão da linguagem do BERT, sendo 60% mais rápido e 40% menor. Isso o torna ideal para aplicações em tempo real, como buscas e análise de sentimentos.
Por que os modelos de pequeno porte vencem no mundo real
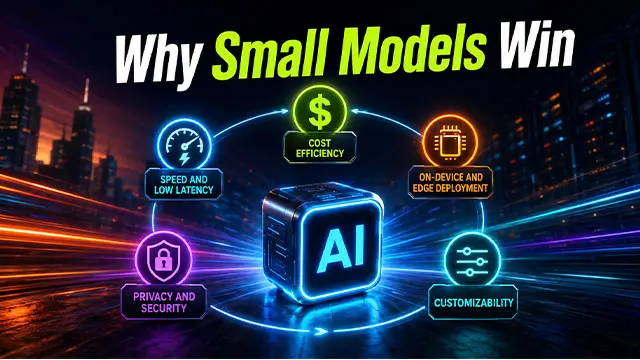
1. Eficiência de custos
Modelos pequenos podem ser executados em uma única GPU ou até mesmo em uma CPU, reduzindo drasticamente os custos de inferência. Para uma empresa que processa milhões de documentos diariamente, um modelo que custa centavos por milhão de tokens é essencial. Uma chamada de API para um modelo de lógica de aprendizado profundo (LLM) massivo pode custar de 10 a 100 vezes mais para a mesma saída.
2. Velocidade e baixa latência
Em chatbots, assistentes de código e aplicativos móveis, os usuários esperam respostas quase instantâneas. Modelos pequenos geram tokens muito mais rapidamente do que seus equivalentes gigantes, tornando-os ideais para uso interativo.
3. Implantação no dispositivo e na borda
Essa talvez seja a maior vantagem. Modelos pequenos podem funcionar inteiramente em smartphones, laptops e dispositivos embarcados sem conexão com a internet. Os modelos básicos integrados da Apple e o Gemini Nano do Google são exemplos dessa tendência. Isso possibilita tradução em tempo real, assistentes offline e inteligência artificial privada e integrada ao dispositivo, que nunca envia dados para a nuvem.
4. Privacidade e segurança
Executar um modelo localmente significa que dados sensíveis — registros médicos, documentos financeiros, fotos pessoais — nunca saem do dispositivo. Isso representa uma mudança radical para setores regulamentados e consumidores preocupados com a privacidade.
5. Personalização
Modelos pequenos são mais fáceis de ajustar com dados específicos de um domínio. Um hospital pode ajustar um modelo 7B com base em seus próprios registros clínicos, obtendo maior precisão para tarefas médicas do que um modelo 175B de uso geral que sabe um pouco de tudo, mas nada específico.
O futuro: especialização em vez de superdimensionamento
De acordo com um relatório de 2024 da Hugging Face , os downloads de modelos de código aberto de pequeno porte estão crescendo mais rapidamente do que os de modelos de grande porte. A empresa de análise de tecnologia Gartner prevê que, até 2027, mais de 50% dos modelos GenAI usados em empresas serão específicos para determinados domínios, um aumento significativo em relação a menos de 1% em 2023. Isso sugere que o futuro da IA não reside em um único cérebro gigante, mas sim em uma rede de modelos especializados e eficientes trabalhando em conjunto.
Conclusão
A ascensão de modelos de linguagem de menor porte marca a maturação da indústria de IA. Embora os modelos de ponta continuem a expandir os limites do possível, o trabalho prático dos negócios e da vida cotidiana será cada vez mais realizado por modelos menores, mais rápidos e com maior privacidade. Nos próximos anos, os vencedores serão aqueles que implementarem o modelo certo para a tarefa certa — e não necessariamente o maior.